FEL
三条常规 MD 重复轨迹联合构建 FEL
适用体系: 同一体系的 3 条独立常规 MD 轨迹,模拟参数相同,仅初始随机速度不同。
本文示例: noMg/system1
CV 选择: 蛋白主链 RMSD + 蛋白回旋半径 Rg
输出目标: 三条轨迹联合的二维自由能景观(FEL)
一、思路说明
FEL 的基本思想是:
- 从轨迹中提取两个能表征构象变化的变量(CV)
- 将每一帧表示为二维坐标 (x, y)
- 统计二维分布概率
- 用 F(x,y)=−RTlnP(x,y)F(x,y) = -RT\ln P(x,y)F(x,y)=−RTlnP(x,y)
将概率转换为相对自由能最后画成二维自由能图
本教程适用于三条同温度常规 MD 重复轨迹。
因为三条轨迹的温度相同,所以不需要做教程里 REMD 那种温度重加权,直接合并三条轨迹的 (x,y) 数据即可。
二、目录准备
你的总目录为:
- /home/databank/ydn/DRAK2/MD/Re/noMg/system1/
其中三条轨迹分别为:
- /home/databank/ydn/DRAK2/MD/Re/noMg/system1/md1
- /home/databank/ydn/DRAK2/MD/Re/noMg/system1/md2
- /home/databank/ydn/DRAK2/MD/Re/noMg/system1/md3
新建 FEL 总目录:
- mkdir -p /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg
- cd /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg
- mkdir md1 md2 md3 csv
三、输入轨迹说明
本流程直接使用每条轨迹已有的:
- analysis/RMSD/dry.xtc
例如:
- /home/databank/ydn/DRAK2/MD/Re/noMg/system1/md1/analysis/RMSD/dry.xtc
以及共同的拓扑文件:
- /home/databank/ydn/DRAK2/MD/Re/noMg/system1/parameters/native.prmtop
这里不再使用 gmx rms,因为之前实践中发现:
- gmx rms 读取 dry-align.xtc 时会出现 triclinic / PBC warning
- 后段 RMSD 会异常飙高到几千
- 不适合作为 FEL 输入
因此本教程统一改为:
直接用 cpptraj 从 dry.xtc 中计算 RMSD 和 Rg
这样更稳。
四、参考结构生成
每条轨迹先提取第一帧作为参考结构 ref_md*.pdb。
md1
- cpptraj << EOF
- parm /home/databank/ydn/DRAK2/MD/Re/noMg/system1/parameters/native.prmtop
- trajin /home/databank/ydn/DRAK2/MD/Re/noMg/system1/md1/analysis/RMSD/dry.xtc 1 1
- trajout /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/md1/ref_md1.pdb pdb
- run
- quit
- EOF
md2
- cpptraj << EOF
- parm /home/databank/ydn/DRAK2/MD/Re/noMg/system1/parameters/native.prmtop
- trajin /home/databank/ydn/DRAK2/MD/Re/noMg/system1/md2/analysis/RMSD/dry.xtc 1 1
- trajout /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/md2/ref_md2.pdb pdb
- run
- quit
- EOF
md3
- cpptraj << EOF
- parm /home/databank/ydn/DRAK2/MD/Re/noMg/system1/parameters/native.prmtop
- trajin /home/databank/ydn/DRAK2/MD/Re/noMg/system1/md3/analysis/RMSD/dry.xtc 1 1
- trajout /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/md3/ref_md3.pdb pdb
- run
- quit
- EOF
注意:
这一步读取 4G 级别 XTC 可能比较慢,跑一两分钟是正常现象,不一定是卡死。
五、用 cpptraj 直接计算 RMSD 和 Rg
这里选用的 CV 为:
- x:蛋白主链 RMSD
- y:蛋白回旋半径 Rg
蛋白残基范围按你当前体系写为:
- :1-292
对齐和计算 RMSD 所用原子为蛋白主链:
- @C,CA,N,O
1)md1_fel.in
在:
- /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/md1/
新建文件 md1_fel.in:
- parm /home/databank/ydn/DRAK2/MD/Re/noMg/system1/parameters/native.prmtop
- trajin /home/databank/ydn/DRAK2/MD/Re/noMg/system1/md1/analysis/RMSD/dry.xtc
- reference /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/md1/ref_md1.pdb
- autoimage
- rms ToRef reference :1-292@C,CA,N,O out /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/md1/rmsd_protein.dat
- radgyr :1-292 out /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/md1/rg_protein.dat
- run
- quit
运行:
- cd /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/md1
- cpptraj -i md1_fel.in
2)md2_fel.in
在:
- /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/md2/
新建 md2_fel.in:
- parm /home/databank/ydn/DRAK2/MD/Re/noMg/system1/parameters/native.prmtop
- trajin /home/databank/ydn/DRAK2/MD/Re/noMg/system1/md2/analysis/RMSD/dry.xtc
- reference /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/md2/ref_md2.pdb
- autoimage
- rms ToRef reference :1-292@C,CA,N,O out /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/md2/rmsd_protein.dat
- radgyr :1-292 out /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/md2/rg_protein.dat
- run
- quit
运行:
- cd /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/md2
- cpptraj -i md2_fel.in
3)md3_fel.in
在:
- /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/md3/
新建 md3_fel.in:
- parm /home/databank/ydn/DRAK2/MD/Re/noMg/system1/parameters/native.prmtop
- trajin /home/databank/ydn/DRAK2/MD/Re/noMg/system1/md3/analysis/RMSD/dry.xtc
- reference /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/md3/ref_md3.pdb
- autoimage
- rms ToRef reference :1-292@C,CA,N,O out /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/md3/rmsd_protein.dat
- radgyr :1-292 out /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/md3/rg_protein.dat
- run
- quit
运行:
- cd /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/md3
- cpptraj -i md3_fel.in
六、检查输出文件是否正常
以 md1 为例:
- head rmsd_protein.dat
- tail rmsd_protein.dat
- head rg_protein.dat
- tail rg_protein.dat
正常现象应为:
- rmsd_protein.dat 前后数值都在合理范围,单位为 Å
- rg_protein.dat 第 2 列为实际 Rg,单位也为 Å
你当前体系中,md1 的输出表现为:
- RMSD 大多数在 2–3 Å
- 最大可到 6 Å 左右,但属于连续构象区间,不是孤立错误帧
- Rg 约在 19.5–20.6 Å 范围
说明这条流程是可用的。
七、提取三条轨迹的 x/y 数据
进入 csv/ 目录:
- cd /home/databank/ydn/DRAK2/MD/Re/noMg/system1/FEL_rmsd_rg/csv
提取 rmsd_protein.dat 和 rg_protein.dat 的第 2 列,组成 x,y 文件。
- awk 'NR>1{print $2}' ../md1/rmsd_protein.dat > md1_rmsd.txt
- awk 'NR>1{print $2}' ../md1/rg_protein.dat > md1_rg.txt
- paste -d, md1_rmsd.txt md1_rg.txt | sed '1ix,y' > md1_xy.csv
- awk 'NR>1{print $2}' ../md2/rmsd_protein.dat > md2_rmsd.txt
- awk 'NR>1{print $2}' ../md2/rg_protein.dat > md2_rg.txt
- paste -d, md2_rmsd.txt md2_rg.txt | sed '1ix,y' > md2_xy.csv
- awk 'NR>1{print $2}' ../md3/rmsd_protein.dat > md3_rmsd.txt
- awk 'NR>1{print $2}' ../md3/rg_protein.dat > md3_rg.txt
- paste -d, md3_rmsd.txt md3_rg.txt | sed '1ix,y' > md3_xy.csv
八、合并三条轨迹
将三条轨迹联合为一个总文件 all_xy.csv:
- (head -n 1 md1_xy.csv && tail -n +2 md1_xy.csv && tail -n +2 md2_xy.csv && tail -n +2 md3_xy.csv) > all_xy.csv
检查:
- head all_xy.csv
- wc -l all_xy.csv
理论上应为:
- 第一行:x,y
- 总行数接近三条轨迹数据之和加 1 行表头
九、根据二维概率分布计算自由能网格
在 csv/ 目录下新建 build_fel.py:
- import numpy as np
- import pandas as pd
- input_file = "all_xy.csv"
- output_file = "fel_grid.csv"
- temperature = 300.0
- R = 0.0019872041 # kcal/mol/K
- x_bins = 80
- y_bins = 80
- df = pd.read_csv(input_file)
- x = df["x"].values
- y = df["y"].values
- H, xedges, yedges = np.histogram2d(
- x, y,
- bins=[x_bins, y_bins]
- )
- P = H / H.sum()
- F = np.full_like(P, np.nan, dtype=float)
- for i in range(P.shape[0]):
- for j in range(P.shape[1]):
- if P[i, j] > 0:
- F[i, j] = -R * temperature * np.log(P[i, j])
- F = F - np.nanmin(F)
- rows = []
- for i in range(len(xedges) - 1):
- for j in range(len(yedges) - 1):
- x_center = 0.5 * (xedges[i] + xedges[i + 1])
- y_center = 0.5 * (yedges[j] + yedges[j + 1])
- rows.append([x_center, y_center, F[i, j]])
- out = pd.DataFrame(rows, columns=["x", "y", "f"])
- out.to_csv(output_file, index=False)
- print(f"FEL grid written to {output_file}")
- print(f"x range: {x.min():.3f} to {x.max():.3f} Å")
- print(f"y range: {y.min():.3f} to {y.max():.3f} Å")
运行:
- python build_fel.py
输出文件:
- fel_grid.csv
其格式为三列:
- x
- y
- f
十、作图
在 csv/ 目录下新建 plot_fel.py:
- import numpy as np
- import pandas as pd
- import matplotlib.pyplot as plt
- df = pd.read_csv("fel_grid.csv")
- x_unique = np.sort(df["x"].unique())
- y_unique = np.sort(df["y"].unique())
- X, Y = np.meshgrid(x_unique, y_unique, indexing="ij")
- F = df["f"].values.reshape(len(x_unique), len(y_unique))
- fig, ax = plt.subplots(figsize=(6, 5))
- cf = ax.contourf(X, Y, F, levels=20, cmap="rainbow")
- cbar = plt.colorbar(cf, ax=ax)
- cbar.set_label("Free energy (kcal/mol)")
- ax.set_xlabel("Protein backbone RMSD (Å)")
- ax.set_ylabel("Radius of gyration (Å)")
- ax.set_title("Free energy landscape from three MD replicas")
- fig.tight_layout()
- fig.savefig("fel_contour.png", dpi=300)
- plt.show()
运行:
- python plot_fel.py
输出图片:
- fel_contour.png
十一、结果解读
你当前得到的图显示:
- 主低能区大致位于
- RMSD ≈ 3.5–4.5 Å,Rg ≈ 19.9–20.2 Å
- 另外在
- RMSD ≈ 5.4–5.9 Å,Rg ≈ 19.4–19.6 Å
- 附近还有一个较低能区
这说明:
三条独立重复轨迹联合后,体系并非只停留在单一构象盆,而是可采样到多个相对稳定构象状态。
十二、几点说明
1)为什么不用教程里的温度重加权脚本
因为你现在的三条轨迹:
- 温度相同
- mdp 相同
- 只是随机初速度不同
所以不需要:
- re_factor = temp / reference_temp
这种多温度重加权逻辑。
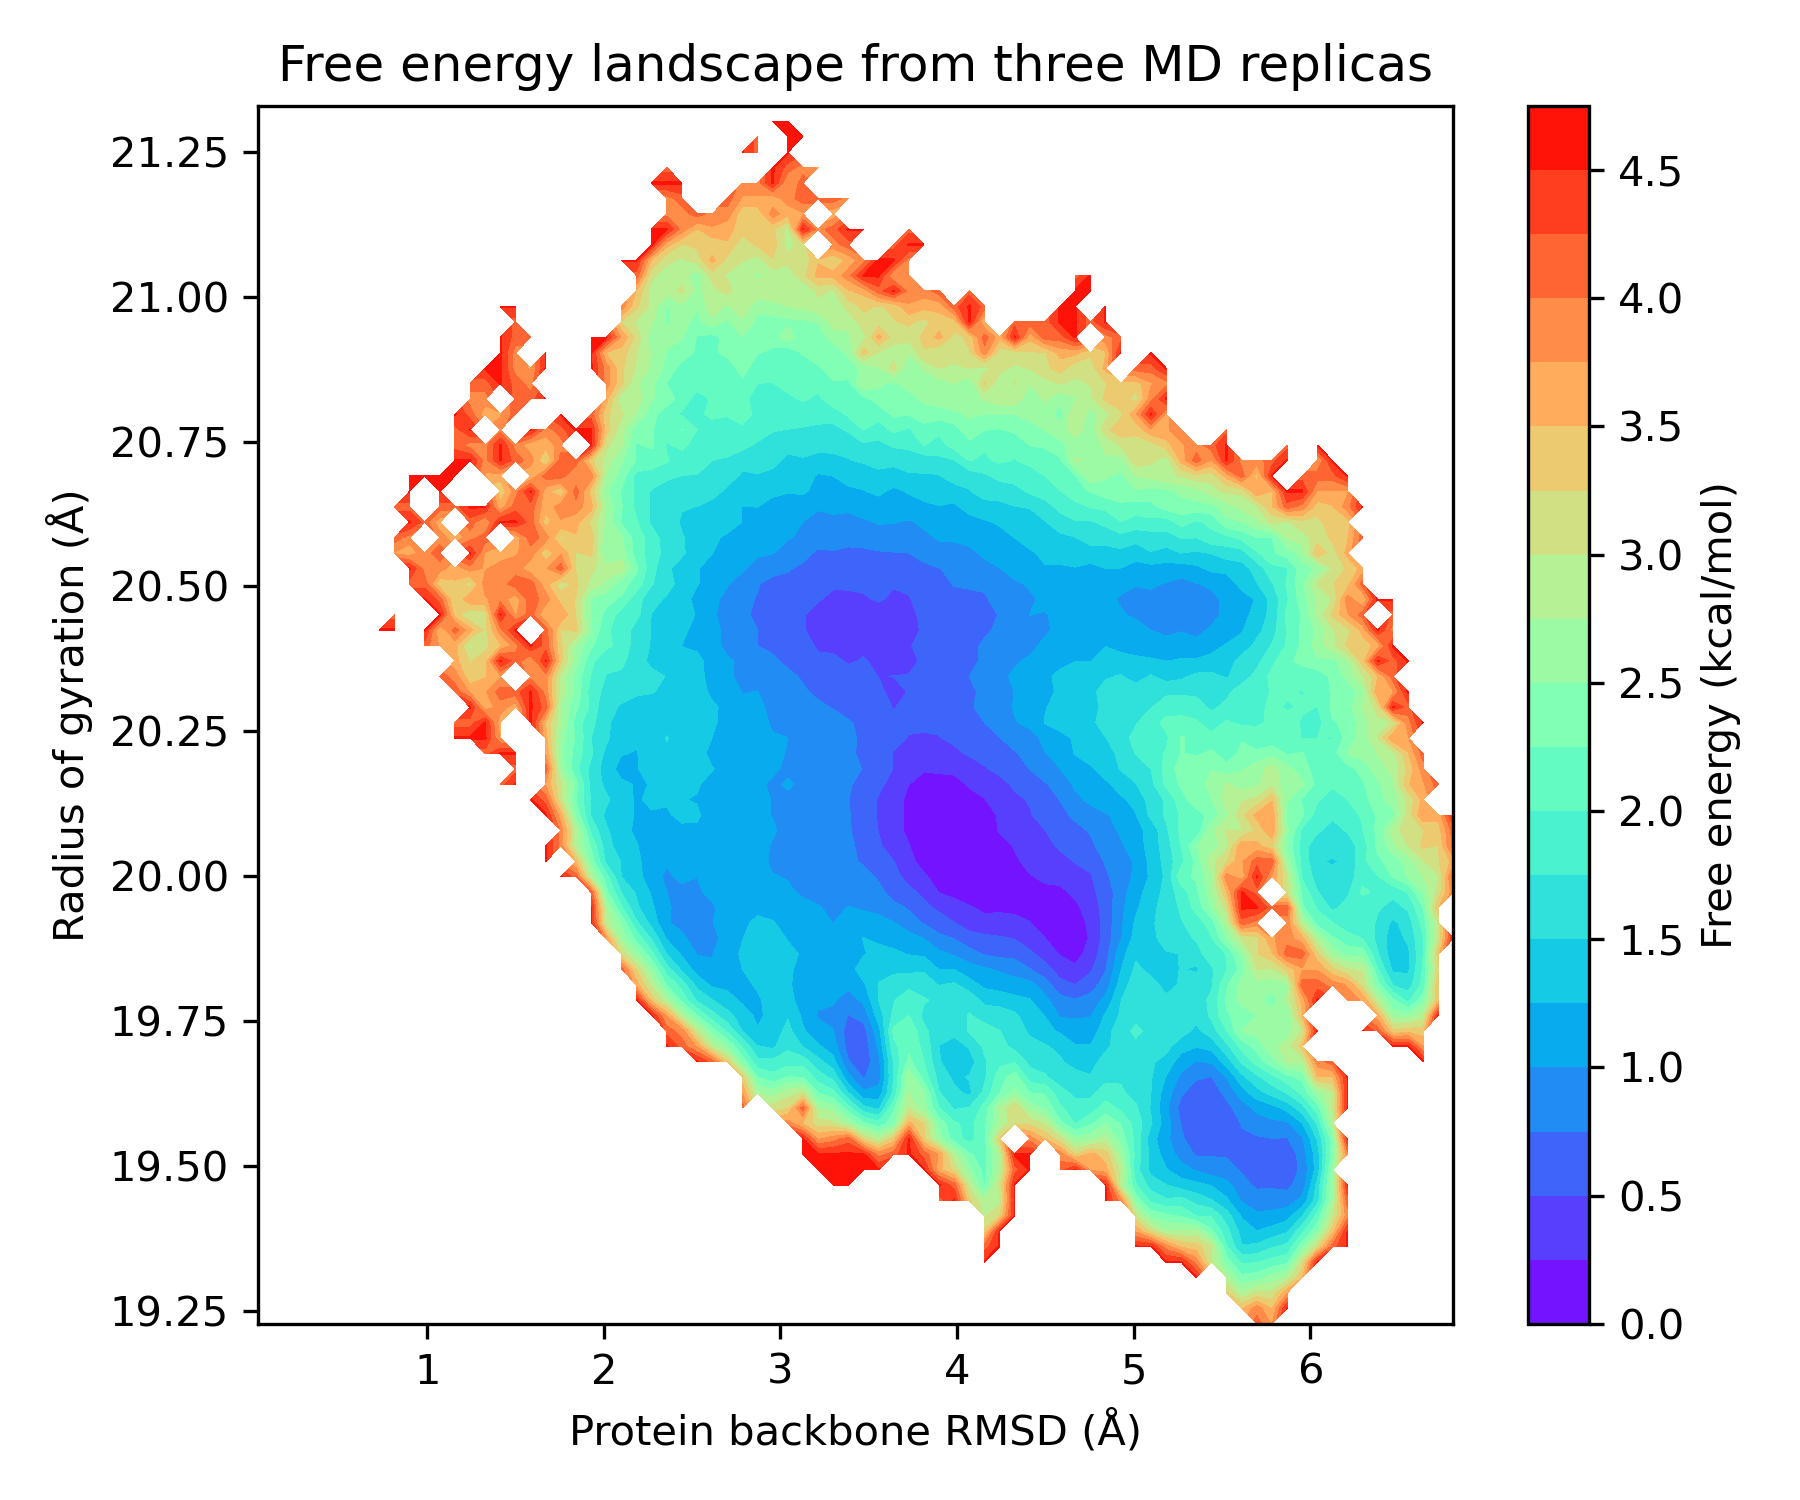
三条独立重复轨迹联合构建的自由能景观显示,体系并非局限于单一构象盆,而是存在多个低能区域。其中主低能盆位于 RMSD 约 3.5–4.5 Å、Rg 约 19.9–20.2 Å,代表体系的主要稳定构象。另一个较低能区域出现在较高 RMSD(约 5.4–6.0 Å)且较低 Rg(约 19.4–19.6 Å)区域,提示体系还可采样到一种更紧凑但构象偏移较大的状态。不同低能区之间通过连续能量分布相连,表明这些构象状态之间存在可逆转变。